来源:多模态智能体 原文链接:https://mp.weixin.qq.com/s/HaWq1UZemBkWMElrFKoQuw
Table of contents#
Open Table of contents
核心结论#
Agent 的核心代码只有一个 while True 循环,整个决策树只有两个分支:模型调工具了?是就执行并喂回去继续循环,否就退出。循环本身没有智能——智能全在模型里,循环只是它的手脚。
理解 Agent 的关键是区分两件事:模型决策和 Harness 执行。模型负责”做什么”(选择工具、构造参数),Harness 负责”怎么做”(实际执行 shell 命令、读写文件)。两者通过 messages 列表连接——模型的输出成为 Harness 的输入,Harness 的执行结果成为模型下一轮的输入。
整个 Agent = 模型决策 + Harness 执行 + 消息历史传递,三件事加在一起就是 Agent。不需要 Planner、Memory、Orchestrator 等复杂概念,那些都是在这三件事基础上叠加的能力。从这篇开始,我们逐层叠加:下一篇 给循环加上工具分发表,后续 叠加 权限和Hooks,一路到 多 Agent 协作。
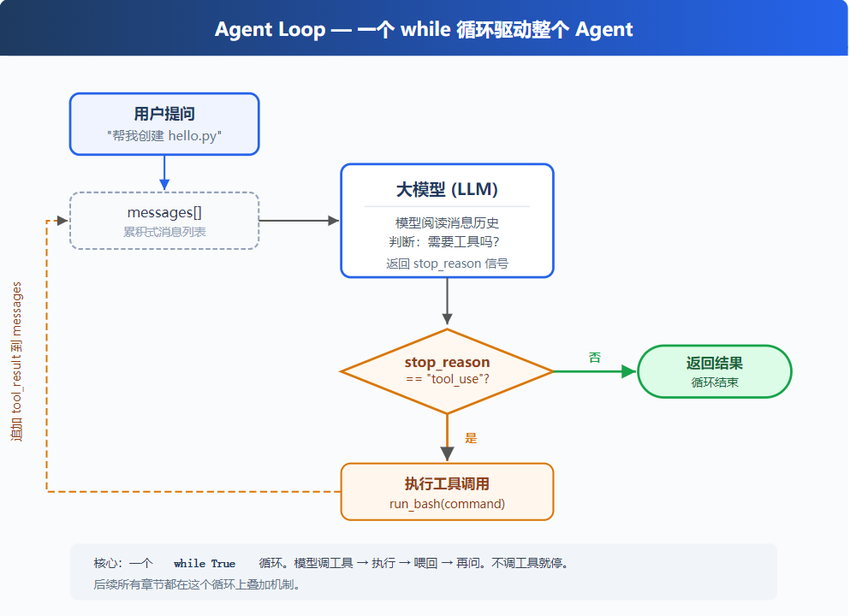 Agent Loop 流程:一个 while True 循环,模型调工具→执行→喂回→再问,不调工具就停
关键洞察#
洞察一:Agent Loop 做的事,就是把你手动复制粘贴的工作自动化#
没有 Agent 之前,你让模型分析文件的工作流是这样的:
- 你输入:“帮我看看这个项目有哪些 Python 文件”
- 模型输出:“请运行
find . -name '*.py'” - 你切到终端,执行命令
- 你把输出复制粘贴回对话框
- 模型看到结果,继续推理
每一次来回你都在做同一件事:把工具结果手动传回给模型。Agent Loop 的唯一贡献就是把这个中间层自动化——循环自动执行模型指定的工具,自动把结果追加回 messages,自动再问一次模型。人类的角色从”搬运工”变成了”监督者”。
洞察二:退出条件不是”模型说完了”,而是”模型没有调工具”#
这两件事不等价。模型可以:
- 一边输出文本一边调工具:比如”让我先看看文件” + 同时调
read_file - 只调工具不说话:直接执行
bash("ls"),不输出任何文字 - 只说话不调工具:输出”我已经完成了”,不调任何工具
我们只关心它有没有举手要工具。这是理解整个循环的关键:tool_calls 是否非空 就继续,否则退出。模型输出的文本内容不决定循环是否继续,只有工具调用才决定。
洞察三:智能在模型里,循环只是手脚#
循环是机械的,没有任何智能。它只负责四件事:
- 把 messages + tools 定义发给模型
- 等模型返回结果
- 如果有工具调用,执行工具并把结果追加回 messages
- 回到第 1 步
真正的决策——调不调工具、调哪个工具、传什么参数——全在模型里。循环只是”手脚”,负责把模型的决策执行出来。这也解释了为什么 Agent 的核心循环代码量可以这么少:它真的只做机械的搬运工作。
洞察四:30 行 vs 1729 行的差距不是”功能多”,而是”保护多”#
Claude Code 的核心文件 query.ts 有 1729 行,但核心循环逻辑和我们这 30 行本质上一样。剩下的 1700 行全是保护机制:
| 保护机制 | 作用 |
|---|---|
| 状态恢复(checkpoint/restore) | 崩溃后从上次检查点恢复,不从头来 |
| Context 压缩 | messages 太长时自动摘要,防止超出上下文窗口 |
| Token 截断重试 | 模型输出被截断时自动续写,不丢内容 |
| 流式并行执行 | 模型还在生成时就开始执行工具,减少延迟 |
| 多路退出策略 | 不只是”不调工具就退出”,还有 maxTurns、用户中断、错误恢复等 |
生产级 Agent 和实验级 Agent 的差距,不在于核心循环多复杂,而在于”出问题时能不能继续跑”。
五步执行流程详解#
| 步骤 | 动作 | 代码实现 | 注意事项 |
|---|---|---|---|
| 1. 用户输入 | 追加到 messages 列表 | messages.append({"role": "user", "content": query}) | 用户输入永远是 role=“user” |
| 2. 调用模型 | messages + TOOLS 一起发给 API | client.chat.completions.create(model=MODEL, messages=..., tools=TOOLS) | TOOLS 是预先定义的 JSON Schema |
| 3. 追加回答 | 把 Pydantic 对象转为纯字典后 append | msg = {"role": am.role, "content": am.content} | 必须转 dict,Pydantic 模型直接塞会报错 |
| 4. 判断退出 | 检查 tool_calls 是否非空 | if not am.tool_calls: return | 不关心文本内容,只看有没有工具调用 |
| 5. 执行工具 | 逐个执行并收集结果 | handler(**json.loads(tc.function.arguments)) | 每个结果通过 tool_call_id 对应到具体调用 |
完整核心函数不到 30 行,但覆盖了 Agent 的全部基础能力。
一个完整的场景推演#
假设用户输入 “帮我创建一个 hello.py 文件并运行它”,Agent Loop 的执行过程:
Round 1:
  用户: "帮我创建一个 hello.py 文件并运行它"
  模型: tool_calls=[write_file(path="hello.py", content="print('Hello!')")]
  执行: write_file → "Wrote 24 bytes to hello.py"
  追加: messages += [assistant_msg, tool_result]

Round 2:
  模型(看到历史): tool_calls=[bash(command="python hello.py")]
  执行: bash → "Hello!"
  追加: messages += [assistant_msg, tool_result]

Round 3:
  模型(看到完整历史): content="文件已创建并运行成功,输出 Hello!"
没有 tool_calls → 退出循环注意每一轮模型都能看到完整的对话历史——包括之前的用户输入、模型回答、工具调用和工具结果。这就是为什么 messages 列表如此重要:它是 Agent 的”工作记忆”。
Anthropic 格式 vs OpenAI 格式#
虽然底层信号一样(“模型有没有举手要工具”),但两个 SDK 的数据格式不同:
| 概念 | Anthropic 格式 | OpenAI 格式 |
|---|---|---|
| 判断是否调工具 | response.stop_reason == "tool_use" | tool_calls 是否非空 |
| 工具调用 ID 字段 | tool_use_id | tool_call_id |
| 工具结果的 role | 嵌在 user 消息里(content 数组中的 tool_result 块) | 独立的 tool 消息 |
| 工具调用块格式 | content 里的 type: "tool_use" 块 | message.tool_calls 数组 |
| 消息追加方式 | assistant 消息直接 append | 必须转为纯字典再 append |
形式不同,但本质信号一样。理解了这一点,切换 SDK 只是改数据格式,核心逻辑不变。
Claude Code 的关键差异#
循环继续的判断方式不同。我们的代码靠 tool_calls 是否非空,CC 用 needsFollowUp 标志位,在流式接收时只要检测到 tool_use 块就设为 true。因为流式响应里 stop_reason 可能滞后——内容块已到,元数据还没更新,只看 stop_reason 在流式场景下可能漏判。
State 对象有 10 个字段 vs 我们只有 messages。比较有意思的两个:maxOutputTokensRecoveryCount(token 截断重试,上限 3 次——模型输出被截断不能当”做完了”)和 pendingToolUseSummary(后台用 Haiku 生成工具调用摘要,压缩 context 长度省 token)。
退出路径从 1 条变成 7+ 条。我们的代码只有一条路(模型不调工具就退出),CC 覆盖了:达到 maxTurns、context 超长(尝试压缩后继续)、token 截断(恢复后继续)、模型报错、用户中断、Stop Hook 拦截、token budget 耗尽……每条路径都有独立的处理逻辑和恢复策略。
流式并行工具执行。CC 的 StreamingToolExecutor 在模型还在生成响应时,对已到达的工具调用就开始执行——不等模型说完。根据工具的 concurrency-safe 标记决定并发还是串行。纯性能优化,但在大量工具调用的任务里能显著减少总延迟。
完整可运行代码#
"""s01_agent_loop.py — Agent 核心循环:30 行代码实现一个能用工具的 AI Agent

运行前准备:
  1. pip install openai
  2. export DEEPSEEK_API_KEY="你的密钥"
  3. python s01_agent_loop.py

这个脚本演示了 Agent 的最简形态:一个 while True 循环,
模型决定调什么工具,循环负责执行并把结果喂回去。
"""
import json, os, subprocess
from openai import OpenAI

# ===== 模型配置 =====
# 使用 DeepSeek API(兼容 OpenAI SDK)
# 也可以换成 OpenAI:client = OpenAI()  MODEL = "gpt-4o"
client = OpenAI(
    api_key=os.getenv("DEEPSEEK_API_KEY"),  # 从环境变量读取 API 密钥
    base_url="https://api.deepseek.com"      # DeepSeek 的 API 地址
)
MODEL = "deepseek-v4-flash"

# ===== System Prompt =====
# 告诉模型它是谁、能做什么
SYSTEM = "You are a helpful assistant with access to a bash shell. Use tools to help the user."

# ===== 工具定义(JSON Schema 格式)=====
# 模型通过这些 Schema 知道自己有哪些工具可用、每个工具接受什么参数
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "bash",
            "description": "Run a shell command.",  # 模型靠这个描述决定什么时候用这个工具
            "parameters": {
                "type": "object",
                "properties": {
                    "command": {
                        "type": "string",
                        "description": "Shell command to execute"
                    }
                },
                "required": ["command"],  # command 是必填参数
            },
        },
    }
]

# ===== 安全黑名单 =====
# 这是最粗粒度的安全措施:某些危险命令直接拒绝执行
# 生产环境会用更复杂的权限系统(见 s03)
DENY_LIST = ["rm -rf /", "sudo", "shutdown", "reboot", "> /dev/"]


def run_bash(command: str) -> str:
    """执行 shell 命令并返回输出

    三层安全检查:
    1. 黑名单匹配:包含危险关键词直接拒绝
    2. 超时保护:30 秒超时防止死循环命令
    3. 异常捕获:任何错误都返回错误信息而不是崩溃
    """
    # 安全检查:遍历黑名单
    for d in DENY_LIST:
        if d in command:
            return f"Error: Dangerous command blocked ('{d}')"
    try:
        # subprocess.run 执行命令,capture_output 捕获 stdout 和 stderr
        result = subprocess.run(
            command,
            shell=True,           # 用 shell 解析命令(支持管道、重定向等)
            capture_output=True,  # 捕获输出而不是打印到终端
            text=True,            # 返回字符串而不是 bytes
            timeout=30,           # 超时保护:防止命令卡死
        )
        # 合并 stdout 和 stderr 一起返回给模型
        return result.stdout + result.stderr
    except subprocess.TimeoutExpired:
        return "Error: Command timed out (30s limit)"


def agent_loop(messages: list):
    """Agent 核心循环 — 整个 Agent 的心脏

    循环逻辑:
    1. 把消息历史 + 工具定义发给模型
    2. 模型返回回答(可能包含工具调用)
    3. 如果有工具调用 → 执行工具 → 结果追加到消息历史 → 继续循环
    4. 如果没有工具调用 → 退出循环

    关键设计:
    - messages 是可变列表,循环内直接修改(append)
    - 每次调用模型都带上完整的 SYSTEM + messages + TOOLS
    - 工具结果通过 tool_call_id 关联到具体的工具调用
    """
    while True:
        # 调用模型:system prompt + 历史消息 + 工具定义
        response = client.chat.completions.create(
            model=MODEL,
            messages=[{"role": "system", "content": SYSTEM}] + list(messages),
            tools=TOOLS,      # 告诉模型有哪些工具可用
            max_tokens=8000,  # 限制模型单次输出的最大 token 数
        )

        # --- 追加模型回答 ---
        assistant_msg = response.choices[0].message
        # 必须转为纯字典!Pydantic 对象直接 append 会导致后续 API 调用报错
        msg = {"role": assistant_msg.role, "content": assistant_msg.content}
        if assistant_msg.tool_calls:
            # 如果模型调了工具,把工具调用信息也转为字典格式
            msg["tool_calls"] = [
                {
                    "id": tc.id,
                    "type": tc.type,
                    "function": {
                        "name": tc.function.name,
                        "arguments": tc.function.arguments,  # JSON 字符串
                    },
                }
                for tc in assistant_msg.tool_calls
            ]
        messages.append(msg)

        # --- 退出判断 ---
        # 核心逻辑:没有工具调用 → 模型认为任务完成 → 退出
        if not response.choices[0].message.tool_calls:
            return

        # --- 执行工具 ---
        for tool_call in response.choices[0].message.tool_calls:
            # 解析模型传来的参数(JSON 字符串 → Python dict)
            command = json.loads(tool_call.function.arguments)["command"]
            # 执行工具,拿到输出
            output = run_bash(command)
            # 把工具结果追加到消息历史
            # role="tool" + tool_call_id 让模型知道这是哪个工具调用的结果
            messages.append({
                "role": "tool",
                "tool_call_id": tool_call.id,  # 关联到具体的工具调用
                "content": str(output),
            })
        # 循环继续:模型看到工具结果后会决定下一步做什么


if __name__ == "__main__":
    messages = []  # 消息历史:整个会话的"工作记忆"
    print("Agent Loop (输入 quit 退出)")
    while True:
        query = input("\n> ")
        if query.strip().lower() in ("quit", "exit"):
            break
        # 用户输入追加到消息历史
        messages.append({"role": "user", "content": query})
        # 进入 Agent 核心循环
        agent_loop(messages)
        # 打印模型最后一条回复(文本内容)
        last = messages[-1]
        if last.get("content"):
print(f"\n{last['content']}")代码运行示例#
运行后你可以试试这些交互:
> 列出当前目录的文件
# 模型会调用 bash("ls -la"),然后告诉你文件列表

> 帮我创建一个 README.md
# 模型会调用 bash("echo '# My Project' > README.md"),然后确认创建成功

> 这个目录下有几个 Python 文件?
# 模型会调用 bash("find . -name '*.py' | wc -l"),然后告诉你数量
每次交互,Agent Loop 都会自动执行工具并把结果喂回给模型,你不需要手动复制粘贴。
当前实现的局限#
| 局限 | 问题 | 解决方案 |
|---|---|---|
| 只有一个工具 bash | 读文件靠 cat,写文件靠 echo >,路径有空格就出问题 | 下一篇 加真正的 read_file、write_file、edit_file、glob |
| 没有权限控制 | 任何命令都能执行,rm -rf / 只靠字符串匹配 | 后续 加三道闸门权限系统 |
| 工具分发是硬编码 | 加新工具要改 agent_loop 函数 | 下一篇 引入 TOOL_HANDLERS 分发表 |
循环本身不需要改动——这正是分发表设计的价值。下一篇 工具分发表 会给它真正的文件操作工具,同时让”加一个工具”变成”加一行代码”的事。
学习笔记#
记录自己的理解和延伸思考
Agent 的本质是什么? 读完这篇最大的感触是:Agent 并没有什么神秘的。它就是一个 while True 循环,不断问模型”你要做什么”,然后帮它执行。真正的智能在模型里,循环只是执行层。这让我想到一个类比:Agent Loop 就像一个人的手脚,模型就像大脑。手脚只是执行大脑的指令,但没有手脚,大脑再聪明也无法与世界交互。
Harness 的重要性被低估了。大多数 AI 教程关注”怎么让模型更聪明”(prompt engineering、fine-tuning),但很少有人关注”怎么让模型的输出真正执行起来”。Claude Code 的 1729 行代码里,核心循环只有 30 行,剩下 1700 行都是 Harness 层的保护机制。这说明生产级 Agent 的难点不在”让模型做对”,而在”模型做错时怎么办”。
这个系列的演进路线。从 s01 到 s15,本质上就是在核心循环上不断叠加保护机制:s02 加工具分发,s03 加权限,s04 加 Hook 解耦,s05 加任务规划,s06 加子 Agent,s07 加技能加载,s08 加上下文压缩,s09 加持久化记忆……每一篇都在回答同一个问题:“模型做错了/做不了/做太多时怎么办”。